验证码对抗(一):文字点选——乱序图还原与坐标定位
从零跑通:脚本自己画图、打乱、还原,复制粘贴就能运行看到结果,再讲 ddddocr 定位与排序。
这篇讲文字点选验证码里最关键的一步——乱序图还原。我把它写成从零开始、复制粘贴就能跑的教程,不需要任何验证码图、也不碰任何网站:脚本自己画一张图、自己打乱、再自己还原给你看。跟着做一遍,你就彻底懂了。
真实的点选验证码长这样,蓝底一根羽毛,上面散着几个彩色的字,要你按提示顺序去点:
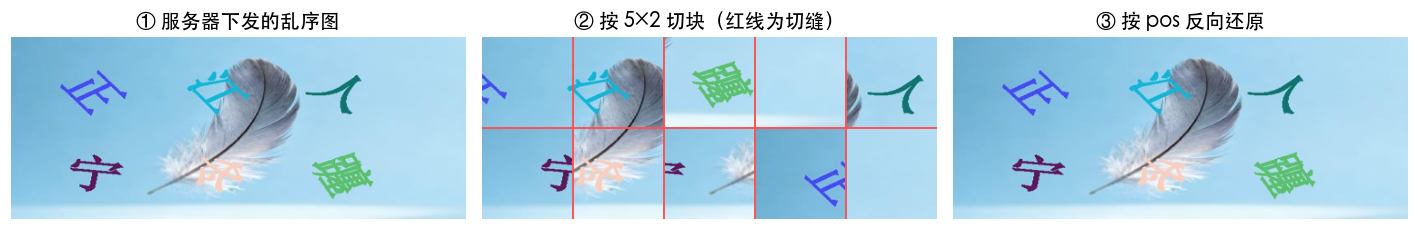
很多站点为了防止你直接把图喂给识别模型,会先把整张图切成网格、把小块打乱了再发给你(浏览器前端再用一份"打乱规则"拼回去给你看)。所以自动识别的第一步,就是拿到规则、把图还原成正常的。这篇就把这一步讲到你能自己跑通。
第一步:装环境
先确认装了 Python 3(命令行输入 python --version 能看到版本号就行)。然后装两个库:
pip install pillow numpy
pillow 是处理图片的,numpy 是做数组运算的。就这两个。
第二步:完整代码,直接复制
新建一个文件 demo_shuffle.py,把下面整段贴进去。这段代码干三件事:自己画一张 5×2 的编号彩格图当素材、按一个 pos 规则把它打乱、再还原回来。
# demo_shuffle.py   依赖:pip install pillow numpy
import numpy as np
from PIL import Image, ImageDraw

# ---------- 第 0 步:自己画一张测试图(10 个编号格子,方便肉眼看还原对没)----------
def make_demo_image(path="demo.png", w=500, h=200):
    img = Image.new("RGB", (w, h), "white")
    d = ImageDraw.Draw(img)
    colors = ["#e57373","#f06292","#ba68c8","#7986cb","#4fc3f7",
              "#4db6ac","#aed581","#ffd54f","#ff8a65","#90a4ae"]
    pw, ph = w // 5, h // 2
    for i in range(10):                       # 从左到右、从上到下,编号 0~9
        r, c = i // 5, i % 5
        d.rectangle([c*pw, r*ph, (c+1)*pw, (r+1)*ph], fill=colors[i])
        d.text((c*pw + pw//2 - 8, r*ph + ph//2 - 8), str(i), fill="black")
    img.save(path)
    return img

# ---------- 第 1 步:按 pos 把图打乱(模拟服务端发下来的乱序图)----------
def shuffle_image(img, x_pieces, y_pieces, pos):
    arr = np.array(img); h, w = arr.shape[:2]
    pw, ph = w // x_pieces, h // y_pieces
    out = np.zeros_like(arr)
    for i in range(x_pieces * y_pieces):
        cur = int(pos[i])
        cr, cc = cur // x_pieces, cur % x_pieces
        tr, tc = i // x_pieces, i % x_pieces
        out[cr*ph:(cr+1)*ph, cc*pw:(cc+1)*pw] = arr[tr*ph:(tr+1)*ph, tc*pw:(tc+1)*pw]
    return Image.fromarray(out)

# ---------- 第 2 步:还原(这就是要掌握的核心)----------
def reverse_shuffle_image(img, x_pieces, y_pieces, pos):
    arr = np.array(img); h, w = arr.shape[:2]
    pw, ph = w // x_pieces, h // y_pieces
    out = np.zeros_like(arr)
    for i in range(x_pieces * y_pieces):
        cur = int(pos[i])                            # 还原图第 i 格,内容来自乱序图第 pos[i] 格
        cr, cc = cur // x_pieces, cur % x_pieces      # 它此刻在乱序图的行、列
        tr, tc = i // x_pieces, i % x_pieces          # 它该回到的行、列
        out[tr*ph:(tr+1)*ph, tc*pw:(tc+1)*pw] = arr[cr*ph:(cr+1)*ph, cc*pw:(cc+1)*pw]
    return Image.fromarray(out)

if __name__ == "__main__":
    X, Y = 5, 2                                        # 切成 5 列 2 行,共 10 块
    POS = [8, 0, 1, 4, 9, 5, 7, 6, 2, 3]              # 打乱规则
    original = make_demo_image()
    shuffled = shuffle_image(original, X, Y, POS); shuffled.save("shuffled.png")
    restored = reverse_shuffle_image(shuffled, X, Y, POS); restored.save("restored.png")
    same = np.array_equal(np.array(original), np.array(restored))
    print("已生成 demo.png / shuffled.png / restored.png")
    print("还原结果和原图是否完全一致:", same)
第三步:运行,看结果
命令行里运行:
python demo_shuffle.py
你会看到这样的输出:
已生成 demo.png / shuffled.png / restored.png
还原结果和原图是否完全一致: True
同时目录下多出三张图,打开对比就是下面这样——中间是打乱的(编号乱了),右边是还原的(编号又变回 0~9,和左边一模一样):
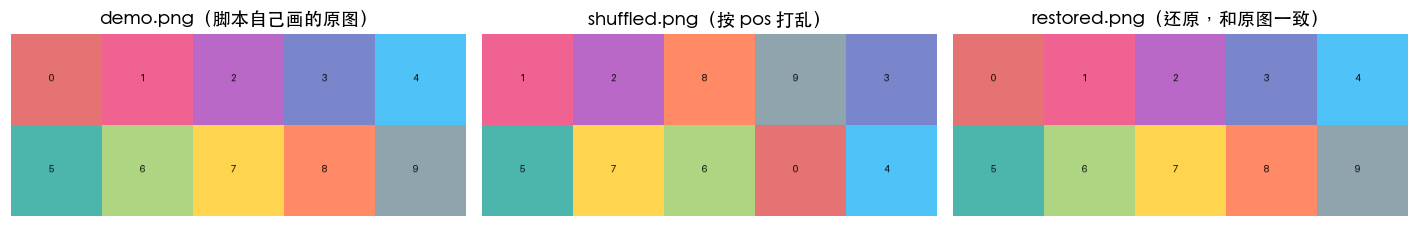
最后打印 True,说明还原和原图逐像素一致。到这里,还原这件事你已经跑通了。
核心原理:pos 到底是什么意思
pos 是长度为 x*y 的数组,把格子从左到右、从上到下编号 0~9。pos[i] 的含义是:还原图里第 i 格,它的内容此刻在乱序图的第 pos[i] 格里。
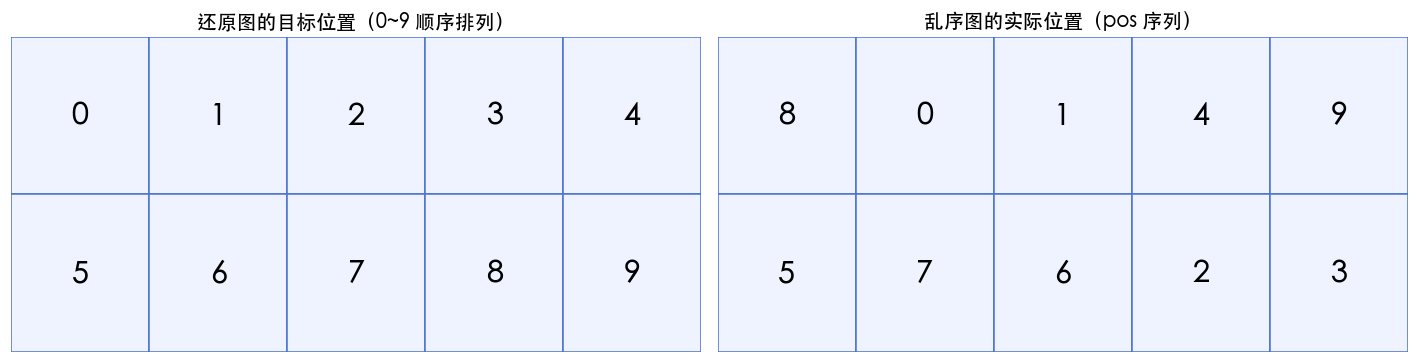
比如 pos[0] = 8,就是"还原图左上角第 0 格,内容现在在乱序图第 8 格"。所以还原就是循环每一格:算出它现在在哪(cur → 行 cr 列 cc)、算出它该去哪(i → 行 tr 列 tc)、把这块像素从"现在"搬到"该去"。行列换算是最常见的一维转二维:编号除以列数得行号,对列数取余得列号。
代码里 shuffle_image(打乱)和 reverse_shuffle_image(还原)几乎一样,只有搬运方向反过来——这也是最容易搞错的地方:如果你还原出来还是乱的,多半是方向反了,把这两个函数里赋值号两边对调一下再试。
真实场景怎么用
真实站点里,你不用自己造 pos,它随验证码接口一起下发,长这样:
shuffle_rule = {'shuffle': {'x': 5.0, 'y': 2.0,
                            'pos': [8.0, 0.0, 1.0, 4.0, 9.0, 5.0, 7.0, 6.0, 2.0, 3.0]}}
你把接口返回的这份规则里的 x、y、pos 取出来,喂给上面的 reverse_shuffle_image,就能把下载到的乱序图还原成正常图。
还原之后:认出字在哪、按什么顺序点
图正了,还要知道"每个字的中心坐标"。用现成的 ddddocr 最省事,它自带验证码目标检测模型。先装:
pip install ddddocr
然后这段能直接跑(对任意一张带内容的图片都能框出目标):
import ddddocr

det = ddddocr.DdddOcr(det=True)                       # det=True 是目标检测模式
with open("restored.png", "rb") as f:
    boxes = det.detection(f.read())                   # 返回每个目标的方框 [x1,y1,x2,y2]

for x1, y1, x2, y2 in boxes:
    cx, cy = (x1 + x2) // 2, (y1 + y2) // 2            # 方框中心 = 点击坐标
    print("一个待点目标的中心:", cx, cy)
det.detection 返回每个目标的外接矩形,取中心就是要点的坐标。
最后是排序。点选一般会给一张"顺序提示条",从左到右就是要点的先后:
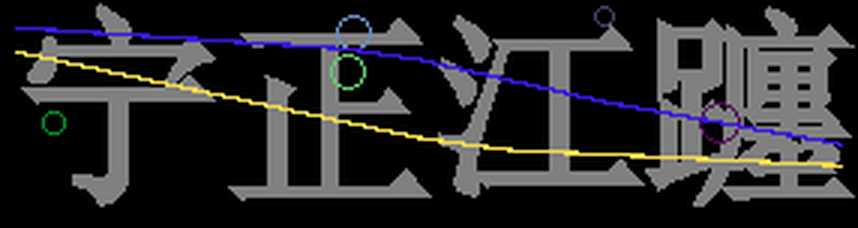
用普通识别模式把提示条里的字读出来,再拿这个顺序去匹配大图上检测到的字,按提示顺序输出坐标:
ocr = ddddocr.DdddOcr()                               # 普通识别模式
text = ocr.classification(open("hint.png", "rb").read())
print("要按这个顺序点:", text)                          # 例如 "宁正江疆"
到这里,"还原乱序图 → 检测每个字坐标 → 按提示排序"这条链路就完整了。拿到坐标之后,怎么把点击做得像人手(而不是瞬间精准命中被拦),是下一篇轨迹的事。
评论 0