极验三代滑块验证码逆向分析:从状态机到请求载荷的完整拆解
一、写在前面:把验证码看成一套协议
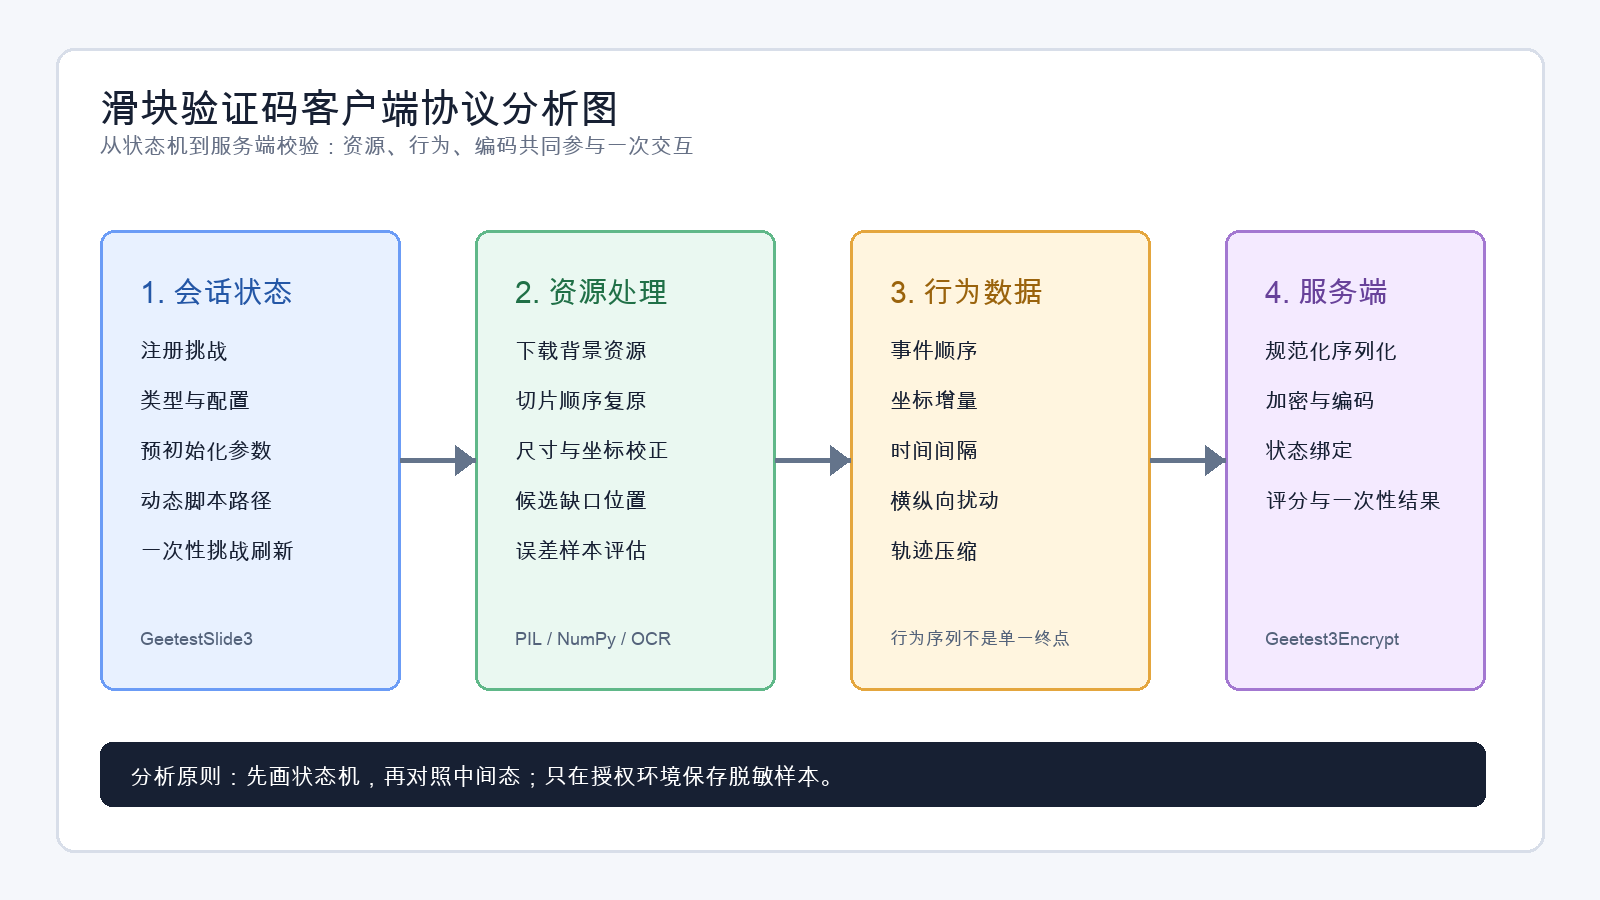
滑块验证码的页面体验很直观:加载背景图,拖动滑块,通过后得到一个结果。但从逆向分析的角度看,它更像一个多阶段、强状态关联的客户端协议。图片缺口只是其中一环,页面运行环境、动态脚本、设备与行为数据、参数序列化以及服务端校验
共同决定一次交互能否成立。
本文基于一个 Python 项目的阅读笔记展开。项目由 gt_slide3.py、geetest_encrypt.py 和 geetest_tool.py 三部分组成,分别负责流程编排、编码封装、网络与图像辅助。本文只讨论分析方法、代码组织和安全防守思路,不公开可直接用于规避验证的接口参数、固定常量、密钥或可运行绕过步骤。请仅在自有系统、授权测试或教学环境中研究。
二、先画流程图:主类其实是一个状态机
GeetestSlide3 把流程拆成 register、gettype、c_s、ajax、img_js、verify 等步骤。每个步骤都会读写实例状态,例如站点标识、挑战值、服务端下发的扰动数据、图片地址、动态脚本路径、轨迹、耗时和最终校验结果。
一次交互可以概括为:
1. 注册阶段取得本轮会话的基础标识和挑战值。
2. 类型查询确认前端配置与可用能力。
3. 预初始化阶段取得后续编码依赖的扰动参数。
4. 行为预热阶段提交初始交互环境。
5. 图片阶段拿到背景资源和动态脚本路径,同时可能刷新挑战值。
6. 脚本观察阶段提取本轮动态字段。
7. 图像处理阶段复原切片并估算候选位置。
8. 轨迹阶段生成时间序列。
9. 提交阶段封装距离、轨迹、环境数据和挑战状态。
10. 服务端返回评分与一次性校验结果。
把它当成状态机后,偶发失败就容易解释:某一步用了旧挑战值,图片获取后没有同步新的会话字段,动态字段与当前脚本不对应,或者提交耗时与轨迹终点时间不一致,都会造成后续校验失配。
三、代码结构:编排、算法和 I/O 分层
gt_slide3.py 的职责是调度,main 按照业务时序推进状态。geetest_tool.py 集中处理 HTTP 请求、脚本和图片下载、图像及轨迹辅助。geetest_encrypt.py 封装参数排序、序列化、加密、字节映射和轨迹压缩。
这样的分层适合快速验证协议,也方便后续维护:页面脚本更新时,通常变化最剧烈的是动态字段和编码层;如果它们与网络流程解耦,排查成本会低很多。
四、代码片段:用状态对象表达流程
原项目通过实例属性保存每一阶段的结果。下面是一个脱敏后的简化写法,重点是表达状态边界,敏感字段不应写入普通日志:
from dataclasses import dataclass, field
from typing import Any

@dataclass
class VerificationTrace:
    challenge: str | None = None
    resources: dict[str, str] = field(default_factory=dict)
    events: list[dict[str, Any]] = field(default_factory=list)
    distance: float | None = None
    elapsed_ms: int | None = None
    status: str = "created"

    def mark(self, name: str, **meta: Any) -> None:
        self.events.append({"stage": name, "meta": meta})


def run_authorized_sample(trace: VerificationTrace) -> str:
    trace.mark("register")
    trace.mark("load_resources")
    trace.mark("analyze_image", result="candidate-only")
    trace.mark("build_local_fixture")
    trace.status = "ready_for_manual_review"
    return trace.status
这种写法让每个阶段都可以单独测试,失败时也能知道停在哪一步。对于真实业务,最终验证应交给服务端,研究代码只保留脱敏样本和中间态摘要。
五、动态脚本:先观察,再翻译
项目会下载服务端指定的前端脚本,并通过运行时观察获取动态字段。这说明协议并不是把固定算法翻译成 Python 这么简单,部分字段、参数名或处理路径可能由当次脚本决定。
稳妥的顺序是:先记录脚本版本、响应摘要、调用时机和输入输出;再定位参与请求生成的函数;最后才把稳定部分转写到目标语言。单纯依赖字符串替换或正则对压缩、变量改名和版本升级都很敏感。动态脚本还应放在隔离环境中运行,记录哈希和来源,不要在生产主机上以无限权限执行远端代码。
六、图像处理:切片复原不等于识别完成
滑块背景在传输层往往不是最终视觉顺序。辅助模块中的图片复原函数依据切片布局把小块重新拼成可比较的背景,再由图像匹配组件计算候选位置。
这一段要拆成三个问题:第一是格式与坐标系,第二是缺口定位算法,第三是业务坐标映射。图像中的候选位置不必然等于前端拖动距离,滑块宽度、边距、缩放比和渲染容器都可能参与换算。
复原逻辑适合写成纯函数,使用授权样本进行回归测试:
from io import BytesIO
from PIL import Image

def rebuild_preview(raw: bytes, layout: list[tuple[int, int, int, int]]) -> bytes:
    """根据已知布局重组授权测试图片。"""
    source = Image.open(BytesIO(raw)).convert("RGB")
    result = Image.new("RGB", source.size)
    for src_x, src_y, dst_x, dst_y in layout:
        tile = source.crop((src_x, src_y, src_x + 10, src_y + 80))
        result.paste(tile, (dst_x, dst_y))
    output = BytesIO()
    result.save(output, format="PNG")
    return output.getvalue()
七、行为数据:重点是时间关系
项目里有前期交互事件和根据目标位置生成的运动序列。编码器会将绝对坐标转成增量,合并连续时间,再使用字符表和路径规则压缩。
从分析角度,重点不是如何伪装行为,而是理解服务端可能检查什么:事件先后关系、首尾停顿、移动密度、横纵方向相关性、总耗时、轨迹终点与提交耗时是否一致,以及这些数据是否与浏览器环境相互印证。对防守方来说,检测同质化分布、异常熵值、跨会话复用和高频模式,比只盯一个距离阈值更有效。
八、载荷封装:重点是规范化与绑定
编码模块通常包含参数排序、紧凑序列化、分组加密、字节映射和自定义编码等层次。最容易踩的坑有四个:序列化细节不一致,编码表或填充规则不一致,挑战状态与轨迹来自不同会话,以及把一次抓包中的固定字段硬编码进去。
调试时应建立中间态对照表:
def assert_stage_output(stage: str, value: object) -> None:
    if value is None:
        raise ValueError(f"{stage}: output is empty")


def compare_fixture(actual: bytes, expected: bytes) -> dict[str, int | bool]:
    return {
        "same": actual == expected,
        "actual_size": len(actual),
        "expected_size": len(expected),
    }
每一步只记录摘要,不记录密钥、Cookie 或完整验证载荷。
九、从代码能看到的稳定性问题
网络辅助函数如果对所有异常统一吞掉并长时间重试,会让错误被掩盖。浏览器版本、渲染器信息、脚本版本和环境字段如果长期硬编码,也会随着平台变化失效。图像下载失败、脚本结构变化、编码差异和服务端拒绝应该分别分类。
网络请求还需要统一管理超时、有限次数重试、指数退避、请求关联 ID 和会话一致性。尤其不要中途切换出口、丢失 Cookie 或跨轮复用挑战状态。
十、网络重试示例
import time
import requests

def fetch_with_retry(url: str, attempts: int = 3) -> requests.Response:
    last_error: Exception | None = None
    for index in range(attempts):
        try:
            response = requests.get(url, timeout=10)
            response.raise_for_status()
            return response
        except (requests.Timeout, requests.ConnectionError) as exc:
            last_error = exc
            time.sleep(0.5 * (index + 1))
    raise RuntimeError("authorized fixture request failed") from last_error
十一、如何把实验项目做得可维护
建议把每轮验证包装成 Trace 对象,记录阶段名、耗时、输入摘要、输出摘要和失败原因;图片与脚本只保存经过脱敏的授权样本。为图像复原、轨迹压缩、规范化序列化和响应解析分别写离线单元测试。
发现动态脚本结构变化时,应做版本检测并停止自动流程,转为人工确认,而不是默默使用旧逻辑继续提交。研究过程还要与真实业务隔离,不用于登录、注册、下单、抢票等操作,也不应包装成批量调用服务。
十二、从防守者视角设计验证码
验证码不能只依赖一个前端加密字段。更可靠的设计是组合一次性挑战、服务端会话、页面完整性、行为统计、风险评分和业务频率控制。
挑战值应短时有效并单次绑定;验证结果由服务端直接消费;图像、脚本、参数格式和行为模型应定期轮换;对异常成功率、重复轨迹、相似设备组合和高频失败建立告警;高风险行为增加二次确认或更强的人机校验。同时要避免过度依赖脆弱的浏览器指纹,以免误伤正常用户。
结语
阅读这套代码后,最有价值的收获不是记住某个字符串如何生成,而是理解现代验证码客户端如何由状态、资源、行为和编码共同组成。图像识别是感知层,轨迹是行为层,编码是传输层,挑战值和服务端评分才是信任层。
做逆向分析时,先画状态机,再做输入输出对照;先隔离动态代码,再追踪协议变化;先建立测试和日志,再谈自动化。保持授权边界与防守视角,技术能力才会真正变成长期可复用的工程能力。
评论 0