从 geetest_crack 看验证码对抗:识别链路、风险边界与防护实践
基于本地 geetest_crack 项目的授权研究笔记:拆解检测、识别、交互与风控链路,并从防守侧梳理一次性挑战、会话绑定、限流和重放检测。
从 geetest_crack 看验证码对抗:识别链路、风险边界与防护实践
本文基于本地
geetest_crack项目做授权安全研究。示例只用于自建靶场、测试环境和防守验证,不针对第三方站点,不公开真实站点参数、一次性 challenge、自动化提交细节或可直接复用的绕过脚本。
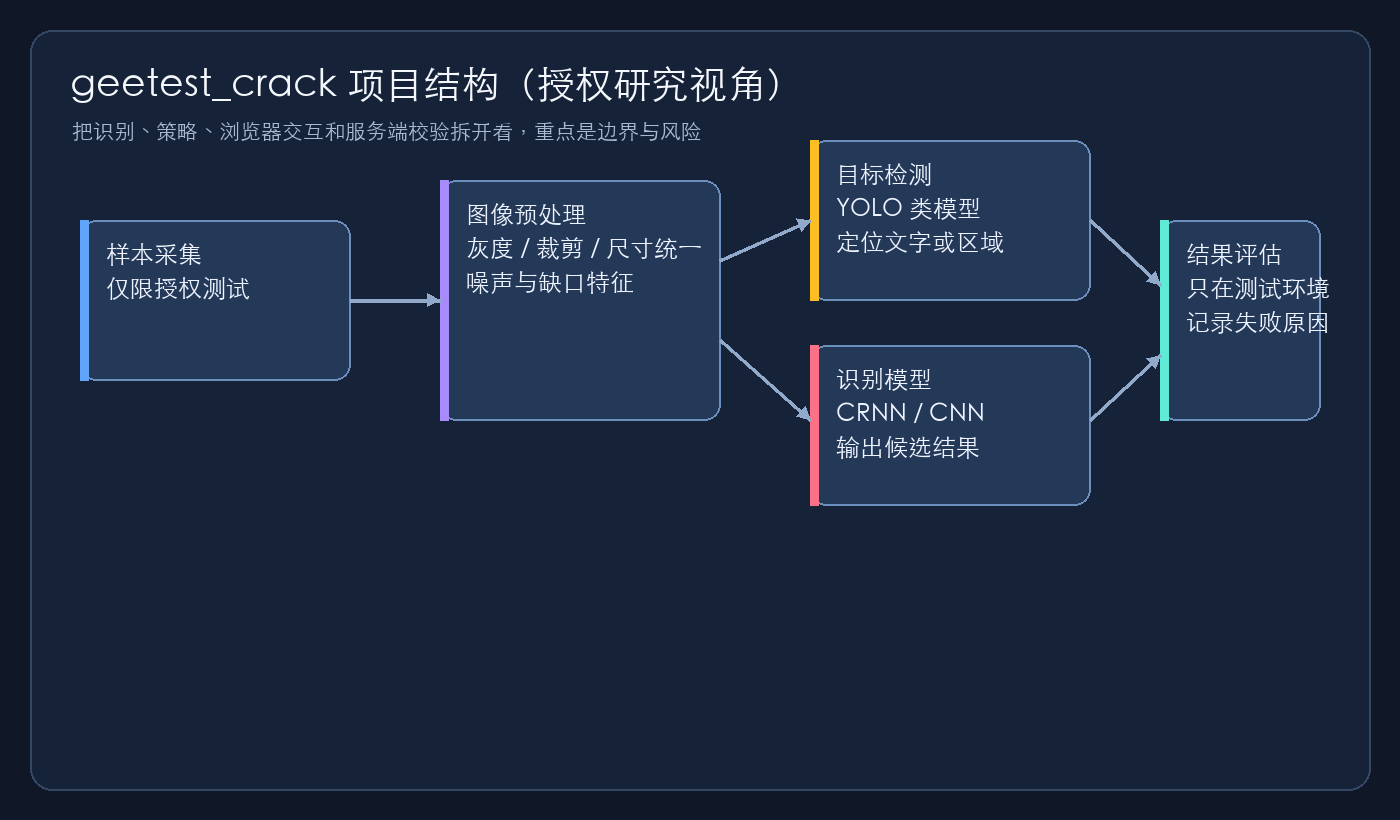
很多人第一次接触验证码项目时,会把问题理解成“找到缺口、识别文字、模拟一次鼠标动作”。但从这个仓库的结构可以看出,验证码对抗实际上是一个完整的工程链路:样本采集、图像预处理、目标定位、文字识别、交互策略、结果校验,以及失败后的重试和风控反馈。
这篇文章不复述“怎么绕过某个站点”,而是借这个项目拆解一套典型的验证码研究流程,并从服务端视角说明哪些地方最容易被滥用、应该怎样补强。
一、先看项目边界
仓库的主要目录可以归纳为三部分:
geeTest/:汉字点选相关的识别模型封装,包含题目识别和目标字符识别。yolo3/:目标检测模型,用于从验证码图片中定位候选文字或区域。imgs/:演示素材和测试图片。
从 README 的说明可以看到,项目同时讨论了滑动、点击和汉字点选等不同类型。它们虽然都被称为“验证码”,但输入信号不同:
- 滑动验证码更关心缺口位置、拖动轨迹、速度变化和结束位置。
- 汉字点选更关心题目文字、候选目标的位置和点击顺序。
- 行为风控还会额外观察设备、浏览器、网络、会话时序和请求频率。
因此,单纯提高图像识别准确率,并不等于真实环境中的验证一定会通过。验证码的核心价值在于“服务端能否判断这次操作是不是可信的人类行为”。
二、一个完整的研究流程
1. 样本采集与脱敏
第一步不是马上训练模型,而是建立可重复的测试集。授权测试时应当只采集自建页面或明确允许测试的页面,并去掉账号、Cookie、手机号、真实业务参数等敏感信息。
建议为每个样本记录:
- 验证码类型和版本;
- 图片尺寸、帧数和压缩格式;
- 题目区域与候选区域的标注;
- 采集时间和测试环境;
- 模型输出、人工结果和失败原因。
样本要按照训练集、验证集和最终测试集分开,不能把同一组图片的轻微变体同时放进训练集和测试集,否则得到的“高通过率”没有参考意义。
2. 图像预处理
项目中的识别模型需要固定尺寸输入。例如,题目识别模型使用单通道图片,并把输入整理成统一的宽高;目标字符识别模型也会把候选区域放进固定尺寸的画布中。
预处理的作用主要有三点:
- 统一模型输入的尺寸和通道;
- 减少压缩、缩放和背景纹理造成的干扰;
- 让训练阶段和推理阶段的输入分布尽量一致。
这里有一个很容易忽视的问题:预处理不能“过度清洗”。如果把阴影、边缘、旋转和干扰全部抹掉,模型在实验图片上可能更稳定,但在真实变化中反而更脆弱。
3. 目标定位
仓库使用 YOLO 类目标检测网络定位汉字候选区域。目标检测的输出通常不是“这个字是什么”,而是候选框、类别和置信度。
可以把它看成一个两阶段系统:
原始验证码图片
        |
        v
目标检测:找到可能的字符区域
        |
        v
裁剪并归一化候选区域
        |
        v
识别模型:判断字符内容
两阶段的好处是把“在哪里”和“是什么”分开,便于分别分析错误。定位错了,后面的识别再准确也没有用;识别错了,则要检查字符裁剪、训练集覆盖和模型混淆类别。
4. 文字识别
项目中可以看到 CRNN、CTC 解码和 CNN 等关键词。它们分别对应不同形式的识别任务:
- CNN 适合固定尺寸、单字符或简单分类;
- CRNN 适合长度不固定的文字序列;
- CTC 用于在没有逐字符对齐标注时,从序列输出中解码文字。
一个安全的实验记录应该至少保存“模型输出”和“置信度”,而不是只保存最终字符串。低置信度样本可以进入人工复核或重新采样流程,不能直接当成可靠结果继续触发业务动作。
三、滑动验证码为什么不只是“补齐缺口”
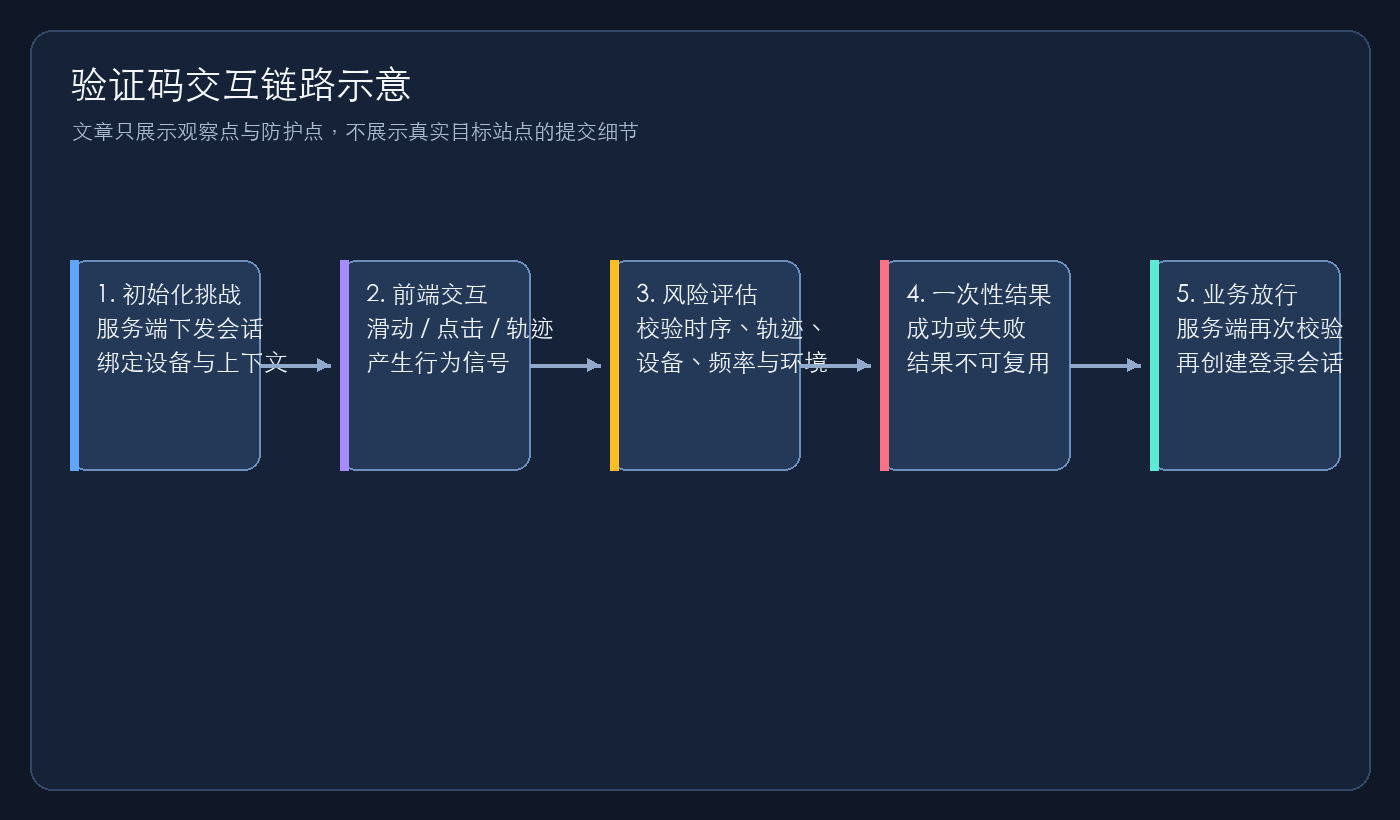
滑动验证通常至少包含三类信号:
- 图像层:缺口和背景形状是否匹配。
- 轨迹层:移动过程中是否存在合理的加速、减速、停顿和微调。
- 环境层:浏览器指纹、设备特征、会话状态、请求频率和接口时序。
所以,服务端如果只校验最终坐标,就会把复杂的风险判断退化成一个容易被重放的单点条件。更稳妥的设计是把轨迹摘要、挑战上下文和一次性随机数绑定在一起,并且在服务端重新计算风险分。
四、汉字点选的工程难点
汉字点选通常包含“题目文字”和“图片中的候选文字”。真正困难的地方不只有识别,还包括:
- 字体变化;
- 相似字和异体字;
- 旋转、遮挡、背景纹理;
- 候选框重叠;
- 点击坐标与图片坐标之间的缩放换算;
- 题目顺序和目标集合之间的匹配。
在授权实验中,建议把流程拆成可观察的中间结果:预处理图、检测框、识别候选、最终匹配。这样可以判断失败发生在哪一层,也方便对防护策略做回归测试。
五、服务端应该怎样防护
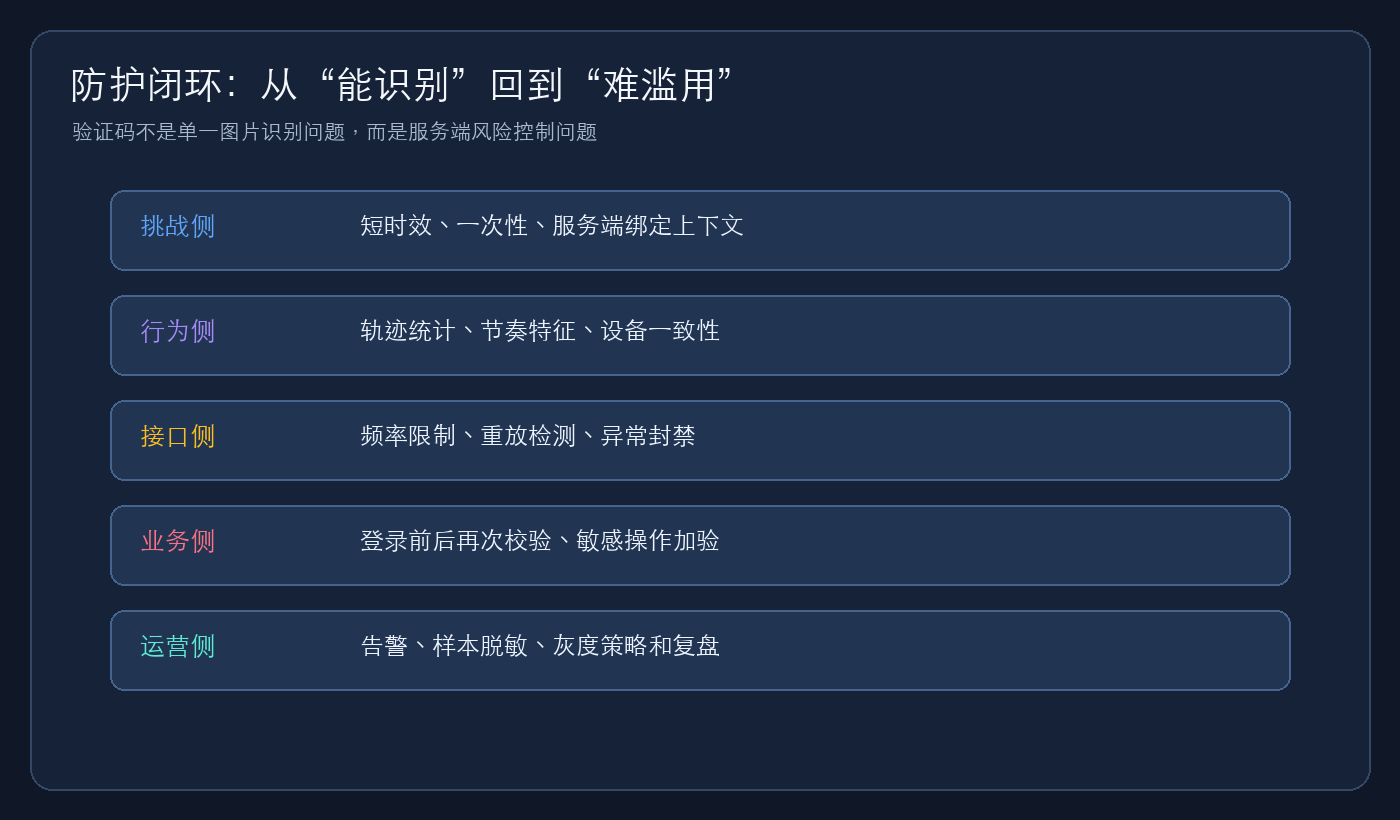
验证码防护不要依赖前端隐藏字段,也不要把“成功标志”单独作为可信依据。业务服务端至少应再次验证挑战是否属于当前会话、是否已经使用过、是否过期,以及行为风险是否达标。
下面是一个防守侧的简化示例,重点是一次性校验、过期判断和频率限制:
def verify_challenge(request, challenge_id, proof):
    challenge = store.get(challenge_id)
    if challenge is None:
        return False
    if challenge.used or challenge.expires_at < now():
        return False
    if challenge.session_id != request.session.id:
        return False
    if rate_limiter.exceeded(request.ip, request.session.id):
        return False

    risk = score_behavior(
        proof=proof,
        user_agent=request.headers.get("user-agent", ""),
        ip=request.client.host,
    )
    if risk < RISK_THRESHOLD:
        return False

    store.mark_used(challenge_id)
    return True
这段代码不是某个平台的接入代码,而是防守侧的最小思路。生产系统还需要加入重放检测、设备一致性、异常代理识别、账号维度限流、敏感操作二次验证和告警审计。
六、如何做一套合规的本地实验
如果要继续研究,推荐建立一个完全自有的测试靶场:
- 自己生成滑块、点选和文字验证码样本。
- 在本地记录图片、轨迹和服务端判定。
- 用模型只做离线识别评估,不连接第三方业务。
- 统计准确率、误报率、漏报率和处理耗时。
- 再加入随机字体、噪声、遮挡和设备变化,观察模型鲁棒性。
- 从防守视角测试重放、频率限制和会话绑定是否有效。
评估指标不要只看“成功率”,还要关注:
- 单样本耗时;
- 低置信度比例;
- 不同设备和网络环境下的稳定性;
- 对人工用户的误拦截率;
- 验证结果是否能够被重放。
七、总结
geetest_crack 这个仓库最值得学习的地方,不是某个具体的识别技巧,而是它把验证码问题拆成了检测、识别和交互多个模块。站在防守角度看,这也说明验证码不能只靠一张图片或一个隐藏参数来保护业务。
更可靠的方案应该是:短时效的一次性挑战、服务端会话绑定、行为风险评分、严格限流、重放检测、敏感操作二次确认,以及完整的日志和告警。只有把这些环节组合起来,验证码才真正具备反自动化的价值。
再次说明:本文仅用于授权测试、模型评估和防护设计。请勿将相关技术用于绕过第三方验证、批量注册、撞库、刷接口或其他未经授权的行为。
评论 0